Marco Mattiucci
Email me
2026-10-30 11:28:29 sentence:
La complessità non è dovuta solo all'ignoranza dell'osservatore.
INFORMATICA
INTELLIGENZA ARTIFICIALE
TRIS (Tic Tac Toe) - gioco
Uso dei prompt
Studio nr. 2 - Gennaio 2026 (con LLM)
seguito dello Studio nr. 1 di Marzo 2025
Abstract - by Notebook LM
I modelli linguistici (LLM) più comuni hanno difficoltà nel Tris, un compito apparentemente semplice che invece mette in luce i loro limiti nel ragionamento spaziale spesso confinato al sequenziale e unidimensionale. Questo lavoro propone strategie di Prompt Engineering avanzato, come la linearizzazione della matrice di gioco e l'adozione di istruzioni assertive positive. Viene inoltre approfondito l'uso del Chain-of-Thought per migliorare la precisione. Attraverso una corretta programmazione in linguaggio naturale si mostra come compensare le carenze native dei modelli per ottenere prestazioni ottimali.
1. Premessa
Finalmente, quale parte 2 dello studio di cui alla pagina Neural Tris di questo sito completo lo studio sul gioco del Tris mostrando come "programmare" un generico LLM (Large Language Model) disponibile su Internet per ottenere un giocatore efficiente (se andate alle conclusioni finali di questa pagina vedrete quanta letteratura scientifica c'è in proposito e che il problema è tutt'altro che semplice).
Nella Studio nr. 1 di Marzo 2025 avevo descritto un complesso percorso attraverso la ridefinizione da zero dei percettroni mediante un software in python. Un esercizio complesso di programmazione che trattava le questioni della programmazione ed apprendimento delle reti neurali più elementari.
In questa pagina invece affrontiamo il problema del Tris mediante l'interazione in linguaggio naturale con un LLM generico per vedere come cambia l'approccio e quale tipo di programmazione si sviluppa in questa circostanza. Su github in questo file di testo ho riportato tutte le istruzioni per creare un file (txt) di prompt da poter somministrare a qualsiasi LLM generico disponibile su Internet per farlo giocare bene a Tris.
2. Primo approccio
Il fatto più interessante da sottolineare subito è che un LLM generico su Internet già conosce un gioco famoso come il Tris per cui gli si può chiedere direttamente tramite prompting di giocare. Quindi si parte subito a interagire e si capisce presto che il giocatore LLM non è molto in gamba. Continuando con il prompting gli si può chiedere di migliorare e di implementare strategie più efficaci. Gli si può imporre, inoltre, di apprendere dagli errori e tutto sembra andare per il meglio, date anche le risposte rassicurative del LLM. Purtroppo, continuando a giocare si capisce che non riesce a migliorare, che spesso fa errori palesi e poi, quasi con ironia li riconosce esso stesso. Tutti gli LLM più comuni e generici reagiscono più o meno in questo modo.
Il passo successivo, molto drastico, è di chiedere al LLM di impiegare algoritimi già implementati in python per operare così da renderlo performante ed efficace. Gli LLM non hanno problemi nel fare questo su richiesta ma, molto interessante, anche impiegando software deterministici perfetti per il gioco del Tris, gli LLM continuano a commettere errori nel giocare. Questa pagina approfondisce le motivazioni di tali errori e il modo per compensarli ottenendo un ottimo giocatore. In questo percorso si comprendono meglio le limitazioni degli LLM e un modo per utilizzarli al massimo per i propri scopi.
3. La Natura Unidimensionale degli LLM
Gli LLM sono progettati per elaborare il linguaggio naturale, che è visto come intrinsecamente sequenziale e unidimensionale, in pratica un flusso di caratteri, una stringa. Tali sistemi realizzano una Tokenizzazione Sequenziale: tutto ciò che ricevono tramite prompting, inclusa una tabella o una matrice, viene convertito in una lunga sequenza di token successivi. Nel caso del Tris la relativa matrice 3x3 non viene vista come una griglia spaziale, ma come una riga di testo, ad esempio:
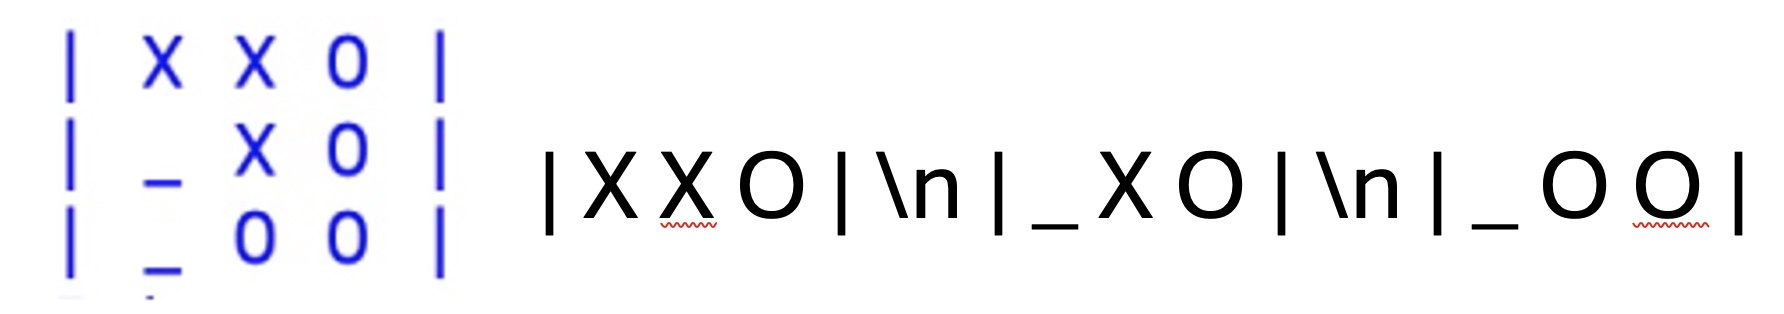
Altro punto molto importante è che gli LLM operano per finestre di contesto, il loro meccanismo di attenzione opera correlando dei token all'interno di una sequenza lineare ad una certa distanza tra loro. In una matrice bidimensionale linearizzata su una riga, come visto nell'esempio di sopra, elementi che risultano vicini tra loro nella tabella 3x3 possono essere a molti token di distanza tra loro, inoltre ci possono essere anche molti token di disturbo inframezzo (ad esempio i new-line o altro usato per disegnare la tabella). Tutto questo influenza il meccanismo di attenzione rendendo difficile per gli LLM di "concentrarsi" su specifici pattern (la stessa semplice individuazione dei tris nella tabella è soggetta a importanti percentuali di errore).
3.1 Un meccanismo di traduzione per il Tris
In questo lavoro si è proceduto a ridurre gli errori di comprensione degli LLM sulla matrice 3x3 del Tris mediante una linearizzazione della stessa fatta in orizzontale, verticale e diagonale.
NOTA:
per linearizzazione della matrice si intende il procedimento informatico con il quale si registra una matrice in RAM linearizzando gli indirizzi di memoria: Index = i * W + j, in matematica questa operazione è chiamata vettorizzazione, mentre nel Deep Learning è chiamata "Flattening" ossia Appiattimento.
Partendo dalla matrice del Tris:
a b c
d e f
g h i
la linearizzazione orizzontale della matrice del Tris è:
[[a,b,c],[d,e,f],[g,h,i]]
la linearizzazione verticale della matrice del Tris è:
[[a,d,g],[b,e,h],[c,f,i]]
infine, la linearizzazione diagonale della matrice del Tris è:
[[a,e,i],[c,e,g]]
La linearizzazione si può vedere come un'operazione di "traduzione" indotta che, peraltro, gli LLM riescono a svolgere molto facilmente e in maniera praticamente deterministica, basta definirla via prompting. Il risultato è che le relazioni spaziali implicite (es. la "colonna 2") divengono relazioni sequenziali esplicite ("il secondo elemento di ogni elemento della linearizzazione orizzontale" oppure "il secondo elemento della linearizzazione verticale"). Il problema di ragionare sullo spazio si trasforma in un problema di pattern matching sequenziale su strutture dati note come le liste (estremamente comprensibili ad un LLM che addirittura, nella tokenizzazione, esclude automaticamente elementi come le parentesi quadre e le virgole, dato che si tratta di un formalismo la cui semantica è nota dal python e da diversi altri linguaggi di programmazione classici).
3.2 Cenno al mondo 3D e nD
Il problema citato, nel mondo a tre dimensioni, non solo persiste, ma si aggrava esponenzialmente. In uno spazio 3D anche ridotto, come ad esempio un cubo di Rubik o una matrice 3D, la serializzazione (riduzione ad una sequenza 1D) è complessa e fondamentale per definire gli input degli LLM ed inoltre la distanza tra i dati correlati nel flusso di token si altera notevolmente:
a) In 1D (Stringa): la vicinanza nello spazio è vicinanza anche nel senso dei token;
b) In 2D (Matrice NxN): due caselle vicine verticalmente sono separate da N token (la lunghezza della riga), nel migliore dei casi 3 token devono essere saltati per trovare il vicino;
c) In 3D (Cubo NxNxN): Due caselle vicine sull'asse Z (profondità) possono essere separate da N × N token.
In generale, più aumentano le dimensioni, più i dati correlati si allontanano nel "nastro" di lettura degli LLM, rendendo il meccanismo dell'attenzione degli LLM più dispersivo e prono agli errori.
3.3 LLM non unidimensionali
Esistono, in ricerca, architetture di LLM che integrano nativamente una sorta di comprensione dello spazio a più dimensioni senza passare brutalmente per il "flattening". Ad esempio modelli come SpatialThinker o Uni3D-LLM vengono addestrati specificamente per "pensare" in 3D. L'approccio è non usare solo testo come input, ma nuvole di punti (point clouds) o coordinate spaziali pure. Anche la tokenizzazione è di natura spaziale: Invece di token di parole, usano token che rappresentano volumi o coordinate, permettendo al modello di mantenere una sorta di "mappa mentale" 3D interna senza doverla serializzare in una stringa lineare.
Quanto detto si inquadra nello sviluppo dei Modelli Linguistici Multimodali di Grandi Dimensioni (MLLM) che, sebbene preminente obiettivo di ricerca, al momento non fornisce ancora risultati ad alto livello di performance. Di fatto il "flattening" e l'impiego di particolari encoder di pre-elaborazione la fanno ancora da "padroni" anche se è stato dimostrato che lo schema di LLM tradizionale da solo non può di principio trattare alcune forme di dati inerenti allo spazio 3D o nD (si pensi agli Spatial-RAG - Spatial Retrieval Augmented Generation - che devono rispondere a domande composte tipo "Trovami un hotel economico (documenti) che sia entro 2km dal centro città (spazio) i quali combinano due motori, uno per la ricerca documentale e l'altro per quella geografica).
4. L'Asserzione positiva negli LLM
Un altro importante aspetto che non permette al LLM generico senza istruzioni di essere un buon giocatore di Tris fin da subito è il tipo di asserzioni su cui basa la sua conoscenza del gioco. Le regole del Tris così come le sue strategie (pienamente note in letteratura) si basano spesso su asserzioni negative: "qualora accada X non fare Y", queste generano di principio degli errori di interpretazione negli LLM. Vediamo nel dettaglio:
4.1 Asserzioni/domande/dubbi
Le frasi assertive positive e i comandi diretti ("Fai A") tendono a produrre risultati più precisi e coerenti rispetto a formulazioni interrogative o dubitative ("Riusciresti a fare A?") negli LLM comuni. Nelle asserzioni positive il meccanismo di attenzione si focalizza subito sull'azione richiesta. Anche il solo uso della cortesia e ancora di più l'inserimento di un dubbio o una domanda ("Riusciresti per favore a fare A?"), determina token aggiuntivi (Potresti, per favore, riusciresti,...) che sviano l'attenzione.
Ancora, le asserzioni positive ("Fai A") sono molto più efficaci e robuste delle asserzioni negative ("Non fare A"). Queste ultime spesso portano a errori o addirittura all'esecuzione proprio dell'azione vietata. Si innesca, infatti, il problema del "Non pensare all'elefante rosa". Anche noi esseri umani, quando ci impongono una negazione, prima evochiamo il concetto da negare (l'elefante rosa) e poi lo neghiamo, la nostra attenzione è proprio lì. Gli LLM operano in modo simile a livello di vettori semantici: se si scrive "Non usare la parola 'blu'", il modello attiva comunque l'embedding (la rappresentazione matematica) del concetto "blu", e l'attenzione si focalizza su "blu", l'istruzione "Non" è un modificatore logico che a volte si "perde" nella complessità della generazione probabilistica, specialmente se la frase è lunga. Il risultato è che il modello ha il concetto "blu" fortemente attivato nel contesto e rischia di usarlo.
Una riflessione rilevante è quella relativa alla definizione dello spazio di ricerca: le asserzioni negative tendono a generare spazi di ricerca della soluzione infiniti o comunque molto ampi. Per fare un esempio pratico l'asserzione positiva "segui il ragionamento X" definisce un'azione e un obiettivo ritagliato precisi, mentre "Non seguire il ragionamento X" apre alla possibilità di innumerevoli altri ragionamenti da cui la possibilità di perdersi.
Un altro aspetto di studio interessante è che quando un LLM affronta una frase lunga o complessa, il "peso" probabilistico della negazione può diluirsi. Consideriamo per il Tris una frase del tipo: "Se il giocatore ha due X, non mettere la O lì, ma mettila altrove."; il modello legge "due X", legge "mettere la O lì" (vicino alla negazione), legge "mettila altrove". La negazione deve invertire il senso di una delle diverse azioni specifiche per cui conta di meno. Se si pone la regola in positivo: "Se il giocatore ha due X su una riga, metti la O nella casella vuota rimanente." si ha un'istruzione diretta per un'azione. Non c'è ambiguità, si tratta di un trigger diretto: Condizione A -> Azione B.
Esempi di prompt ricorrenti:
- Invece di: "Non scrivere risposte lunghe."
conviene "Scrivi risposte brevi e sintetiche.".
- Invece di: "Non dimenticare le regole."
conviene "Applica rigorosamente tutte le regole elencate.".
- ecc.
4.2 Tutto in positivo per il Tris
In questo lavoro tutte le indicazioni per gli LLM sono stati realizzati in maniera assertiva positiva. Ad esempio, considerando la linearizzazione di cui al par. 3.1. già svolta, l'asserzione negativa "Non inserire una X fuori dalle diagonali se sono libere" è stata trasformata in 3 asserzioni positive:
(*) se in uno dei vettori della "linearizzazione orizzontale Tris" c'è una X e due _, metti una X al posto di una delle _ che sono all'inizio o alla fine del vettore.
(**) se in uno dei vettori della "linearizzazione verticale Tris" c'è una X e due _, metti una X al posto di una delle _ che sono all'inizio o alla fine del vettore.
(***) se in uno dei vettori della "linearizzazione diagonale Tris" c'è una X e due _, metti una X al posto di una delle _ che sono all'inizio o alla fine del vettore
che, sebbene siano più articolate e meno comprensibili per noi esseri umani, risultano facilmente recepibili e applicabili dal LLM e inoltre non presentano ambiguità.
4.3 Piccola nota sul LLM tuning
La maggioranza degli LLM moderni passa attraverso una fase specifica di addestramento chiamata Instruction Tuning (RLHF - Reinforcement Learning from Human Feedback). In questa fase, il modello viene premiato quando risponde alle richieste nel modo più preciso e diretto possibile. Di conseguenza l'imperativo attiva direttamente i percorsi neurali ottimizzati per l'esecuzione del compito (task execution), mentre le domande attivano percorsi più "conversazionali" (chatting), che sono più "flessibili" e talvolta meno rigorosi logicamente nel trovare le risposte. Dato che il Tris è un gioco matematico estremamente rigoroso, le istruzioni imperative attivano prestazioni massime del LLM (che ovviamente non è detto risultino tali anche per obiettivi diversi dal Tris).
5. Uso per il Tris del Chain-of-Thought (CoT)
Il Tris è comunque un gioco articolato che vede diverse fasi di valutazione. Un LLM generico conoscendo già il gioco tende ad applicare la sua conoscenza in blocco (sia delle regole che di eventuali strategie) inserendo altri errori oltre quelli segnalati nei paragrafi precedenti. Proprio in questo senso deve intervenire il Chain-of-Thought (CoT), ossia una strutturazione dei prompt che spinge il modello a scomporre il problema in passi intermedi così che i vincoli vengano applicati prima di produrre la risposta finale. In pratica si imposta una struttura del tipo “Fai A, poi B, poi C,...”, ma l’idea centrale è che ogni passo è costruito per ridurre l’ambiguità del passo successivo. In questo modo, invece di selezionare direttamente la risposta finale tra tante, il LLM la seleziona progressivamente riducendo la probabilità di errore.
Specificamente per il Tris la CoT è stata applicata in questo modo: (a) controlli condizioni per fine partita (vittoria, sconfitta, parità), (b) poi minacce immediate (difesa), (c) poi mosse posizionali (attacco), (d) e solo alla fine mossa a caso qualora non si possa applicare nessuna regola. Questa sequenza forza un ragionamento procedurale (prima i vincoli forti, poi quelli deboli), che è esattamente quello che il CoT determina.
La sequenza: analisi → sotto-problemi → conclusione del CoT non è solo una strategia di prompting molto efficace ma anche un metodo di training degli LLM. Si tratta di uno dei metodi per migliorare le capacità di ragionamento dei modelli. Invece di addestrarli solo a dare la risposta finale corretta, li si addestra a generare il percorso logico per arrivarci. Il Fine-Tuning con CoT (CoT Fine-tuning) consiste nel raffinare il modello pre-addestrato utilizzando dataset specifici dove ogni esempio è costituito da tre parti:
a) Input: La domanda o il problema.
b) CoT (Ragionamento): La spiegazione passo-passo.
c) Output: La risposta finale.
l'obiettivo è insegnare al modello che il CoT è parte integrante della risposta, non un accessorio. I modelli addestrati in questo modo imparano a generare spontaneamente catene di pensiero interne prima di rispondere, anche senza che l'utente lo chieda esplicitamente nel prompt.
6. Programmiamo un LLM per giocare a Tris
Su github in questo file di testo ho riportato tutte le istruzioni per creare un file (txt) di prompt da poter somministrare a qualsiasi LLM generico per farlo giocare bene a Tris. Il prompt di partenza per caricare il file è il seguente:
Leggi il file allegato e processa le istruzioni/prompt una alla volta, confermandomi l'apprendimento di ogni punto prima di passare al successivo
Si definiscono prima i concetti di "matrice del Tris", "linearizzazione" orizzontale e verticale, "Tris" di un simbolo, "Tris pieno" e quindi la parità, "cuore del Tris" la casella centrale della tabella. Tali concetti sono confermati da una struttura del prompt del tipo. "Da ora in avanti X è definito in questo modo". Le definizioni si innestano nel senso che alcune definizioni successive impiegano quelle precedenti già confermate.
Successivamente si chiede al LLM di fare uso anche della sua eventuale conoscenza pregressa del gioco facendo attenzione, però, ad impiegare le strategie che seguono, atte a correggerne errori e confusione.
Seguono, quindi i prompt per le condizioni di fine partita, poi quelli per la difesa, le strategie di attacco e infine la regola di uscita finale per una mossa a caso qualora non si possa applicare nessuna regola. Il tutto sempre utilizzando un linguaggio procedurale fortemente collegato alle definizioni date nei prompt precedenti.
Questa impostazione fatta di definizioni di concetti, di procedure e di CoT non solo rende il LLM più preciso nel giocare ma gli permette di spiegare ad ogni mossa il perchè di quello che ha scelto di fare (explainability).
7. Conclusioni
La scelta di implementare il gioco del Tris su LLM non è certamente giustificata dal tipo di gioco ma è un esercizio che risulta oltremodo utile per far capire come interagire con gli LLM nel senso di programmarli a svolgere delle attività logico/matematiche. La comunità scientifica ha analizzato il Tris sugli LLM a fondo concludendo che il Tris è un test di "grounding" (ancoraggio alla realtà spaziale) dove gli LLM attuali falliscono strutturalmente a meno che non intervenga un umano a fare da "traduttore" tra lo spazio 2D e la logica sequenziale 1D (come fatto in questo lavoro) tramite Prompt Engineering avanzato (linearizzazione + regole assertive).
Per chi volesse approfondire:
(1) Andrew Gelman e altri statistici nel lavoro AI can solve math olympiad problems but flunks tic-tac-toe sottolineano il seguente paradosso: un LLM può risolvere problemi complessi delle Olimpiadi di Matematica (che richiedono ragionamento astratto simbolico appreso dai libri), ma fallisce a Tris;
(2) Davide Liga e Luca Pasetto (Studi su Ragionamento Spaziale) hanno pubblicato lavori specifici come Testing spatial reasoning of Large Language Models: the case of tic-tac-toe" evidenziando che diversi LLM, giocando a Tris contro l'algoritmo Minimax (giocatore perfetto) perdevano senza scampo;
(3) Lavori di ricerca quali GTBench: Uncovering the Strategic Reasoning Limitations of LLMs via Game-Theoretic Evaluations hanno evidenziato come gli LLM falliscono miseramente in giochi deterministici a informazione completa come il Tris se lasciati "a braccio". Ciò è dovuto al confermato limite principale della mancanza di ragionamento spaziale nativo.
Cookie(s) & Privacy
Questo sito web, per quanto da me programmato e realizzato in php, non emette cookie, non effettua il profiling dell'utente e non raccoglie vostri dati personali. Alcuni cookie possono essere emessi dal cloud che lo supporta, strumento al di fuori della possibilità di controllo dello scrivente. Per qualsiasi dubbio in proposito smettete immediatamente la navigazione.marcomattiucci.it
Informatica:
Intelligenza artificiale:
- Home(AI)
- AI forte
- AI debole
- AI distribuita
- AI sociale
- Singolaritá
- La Logica
- AI e Leggi
- AI ed Etica
- Tris parte 1
- Decision making
- Tris parte 2 (LLM)