Marco Mattiucci
Email me
2026-10-30 10:36:37 sentence:
Ogni attimo vissuto consapevolmente è un passo verso la serenità.
INFORMATICA
INTELLIGENZA ARTIFICIALE
Strategie per decidere
Studio del 31 Dicembre 2025
Abstract - by Notebook LM
Si analizzano diverse strategie decisionali applicate alla gestione di problemi complessi, utilizzando simulazioni software basate sulla teoria delle code. Si esamina e si dimostra come le richieste di servizio tendano a presentarsi in gruppi o cluster. Attraverso il confronto di vari profili comportamentali, emerge che la gestione concorrente e parziale dei compiti risulta la più efficiente, superando approcci puramente sequenziali o focalizzati solo sulle criticità maggiori. Lo studio evidenzia inoltre che un uso eccessivo del concetto di priorità degrada le prestazioni complessive del sistema, rallentandone la produttività. Infine, viene dimostrato che le strutture gerarchiche ottimizzano i risultati quando il coordinatore opera in modo simultaneo e parziale su più fronti mentre i collaboratori agiscono con metodo sequenziale.
1. Premessa
Nell'ambito dei miei studi sulla teoria delle code di servizio ho potuto sperimentare, mediante un software da me appositamente realizzato in python e liberamente disponibile:
github.com/mmattiucci2024/service_line
interessanti aspetti del decision making, ossia dei metodi decisionali in presenza di problemi complessi e multipli sia per decisori singoli e indipendenti che per strutture gerarchiche decisionali. Le simulazioni del citato software mostrano evidenti vantaggi nell'assumere alcune tipiche strategie quando ci si trova ad affrontare questioni complesse. Tali strategie possono essere assumibili tanto in ambito puramente umano (management) che in quello informatico (sistemi di elaborazione e AI).
Qualora non vogliate spendervi nelle questioni matematiche e informatiche che analizzo in dettaglio e vogliate andare direttamente alle conclusioni (che invece sono molto comprensibili e rapportate ad aspetti umani e gestionali) vi consiglio di andare subito al paragrafo 8, l'ultimo, non capirete come sono state desunte ma sono sicuro che sorriderete e vi ritroverete in alcune di esse (i simulatori raramente mentono...).
2. Problematiche multiple e clustering
Partiamo dal considerare una linea temporale discreta fatta di slot che si susseguono e che da adesso in avanti chiameremo unità temporali ti. Si parte da un tempo discreto t0 e si procede di unità in unità sempre e solo in avanti fino a tN dove N è il numero massimo di unità temporali che caratterizza la nostra simulazione.
Ad ogni unità temporale ti può essserci l'arrivo o meno (in maniera esclusiva) di una richiesta Rj di risoluzione di un problema PROBLEMAj. La probabilità che arrivi la richiesta in un qualsiasi slot temporale considerato è p. In particolare si considera p piccolo (molto minore di 1) ossia si stanno trattando problemi rari. Se p fosse grande o prossimo a 1 allora si trattarebbe di problemi deterministici insiti nel contesto in studio e questo richiederebbe di rivedere l'intero sistema e non solo sviluppare una strategia di gestione dinamica (i problemi deterministici non richiedono abilità di management ma piuttosto reingegnerizzazione della struttura di risoluzione).
Oltre alla rarità degli arrivi si considererà un'altra notevole approssimazione, ossia che non ci sia memoria. In definitiva che arrivi una richiesta all'istante th non dice nulla sul fatto che potrebbe arrivare o meno un'altra richiesta in un qualsiasi istante ti con i > h. Questo in natura è proprio raro e probabilmente in ambito macroscopico non si realizza mai (tutti i sistemi macroscopici che ci ruotano attorno sono comunemente interrelati tra loro e nel tempo); in ogni caso è un'approssimazione utile ai fini della simulazione ion quanto semplifica molto lo studio per cui la si prenderà per buona.
Per finire con le ipotesi, ogni PROBLEMAj avrà una complessità che verrà misurata in base al numero minimo di unità temporali che richiede per essere completamente risolto (nell'ipotesi di dedicarsi solo a lui...), indicheremo tale valore con PESOj.
Il software realizzato può emulare una coda singola di lavorazione dei problemi così come descritti e valutare delle metriche di performance. La simulazione è dinamica e basata di sistemi pseudo-random che emulano gli arrivi casuali con probabilità p delle richieste ad ogni unità temporale e la risoluzione passo-passo dei correlati problemi. Un primo risultato della simulazione a mio avviso molto interessante è che nonostante l'ipotesi di completa casualità e rarità degli arrivi nonchè l'assenza di memoria dei fatti procedendo nel tempo, tali arrivi tendono a raggrupparsi in cluster, ossia in gruppi e non si presentano praticamente mai in maniera regolare, ossia uniforme nel tempo.
Di seguito una linea temporale con N = 3000 e p = 0.013, in rosso sono stati evidenziati i cluster degli arrivi (output del software):

come si può facilmente capire dalla figura i casi di arrivi non raggruppati sono pochi, praticamente solo due: R9 e R27, tutto il resto trova modo di accorparsi in cluster più o meno grandi.
Prima di affrontare gli interessanti risvolti di questo fenomeno a livello decisionale, riporto di seguito una dimostrazione davvero elementare e pratica della sussistenza di tale comportamento (i puristi potrebbero avere problemi nel considerarla ma a livello ingegneristico e pratico aiuta molto):
Dimostrazione:
Partiamo dall'ipotesi che gli arrivi siano regolari nel tempo con una cadenza k di arrivo (ossia ad ogni k unità temporali un arrivo si presenta quasi per certo), questo vorrebbe dire che in N slot che rappresentano tutta la linea temporale discreta si avrebbero m = N/k arrivi e N-N/k = N-m non arrivi. Nella considerazione che la cadenza k non è detto parta da 0 potremmo avere almeno k possibili partenze compatibili con la regolarità nel tempo degli arrivi stessi. Trattandosi poi per ipotesi di eventi tra loro indipendenti si può calcolare la probabilità che si verifichi la regolarità:
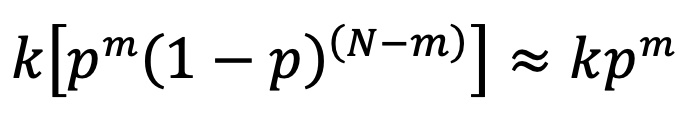
la clusterizzazione e quindi la non regolarità si può valutare nello stesso modo prendendo in considerazione tutte le rimanenti configurazioni che (appunto) escludono l'uniforme distribuzione rispetto al tempo. Ricordando che le combinazioni si determinano con il coefficiente binomiale non è diffcile scrivere la probabilità di clusterizzazione come segue:
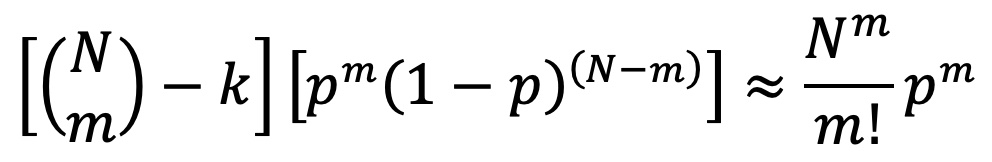
(le approssimazioni riportate hanno senso per p piccolo, come si era ipotizzato: evento raro) dato che k può andare da 1 a N e che Nm/m! è un numero di grandi dimensioni è palese che la probabilità di clusterizzazione degli arrivi (irregolarità) è comunemente molto più alta di quella di regolarità nel tempo degli stessi.
Passiamo quindi ora alle considerazioni di natura decisionale: il decisore/esecutore che vede arrivare la richiesta nell'unità temporale ti dopo un periodo di relativa calma (assenza di arrivi) sa, con buona ragione, che presto deve attendersi nuove richieste per ti+1, ti+2, ti+3, ecc.. In pratica gli arrivi di problemi rari sono segnalatori che dicono di prepararsi all'approssimarsi di altri problemi simili nel vicino futuro. La strategia decisinale migliore di fronte all'arrivo del primo evento raro dopo tempo (inizio del cluster) non è quella di affrontarlo come sempre ma piuttosto
Si sottolinea, per finire, che tutto questo si evince, al momento, senza coinvolgere il tempo di risoluzione di ogni problema (gestione della possibile coda) e senza uso di memoria dei fatti. Andando a includere anche tali aspetti nello studio la situazione peggiora e l'aspetto oracolare del primo problema del cluster è sempre più evidente.
3. Gestione richieste (strategie e performance)
Passiamo ora a considerare una coda di gestione singola (ad un solo decisore/esecutore) dei problemi "rari" di cui al paragrafo precedente. All'unità temporale ti può arrivare una richiesta Rj di risoluzione del PROBLEMAj che ha un PESOj (nella figura che segue Pj per comodità) il quale impegnerà l'esecutore per un certo numero minimo di slot temporali.
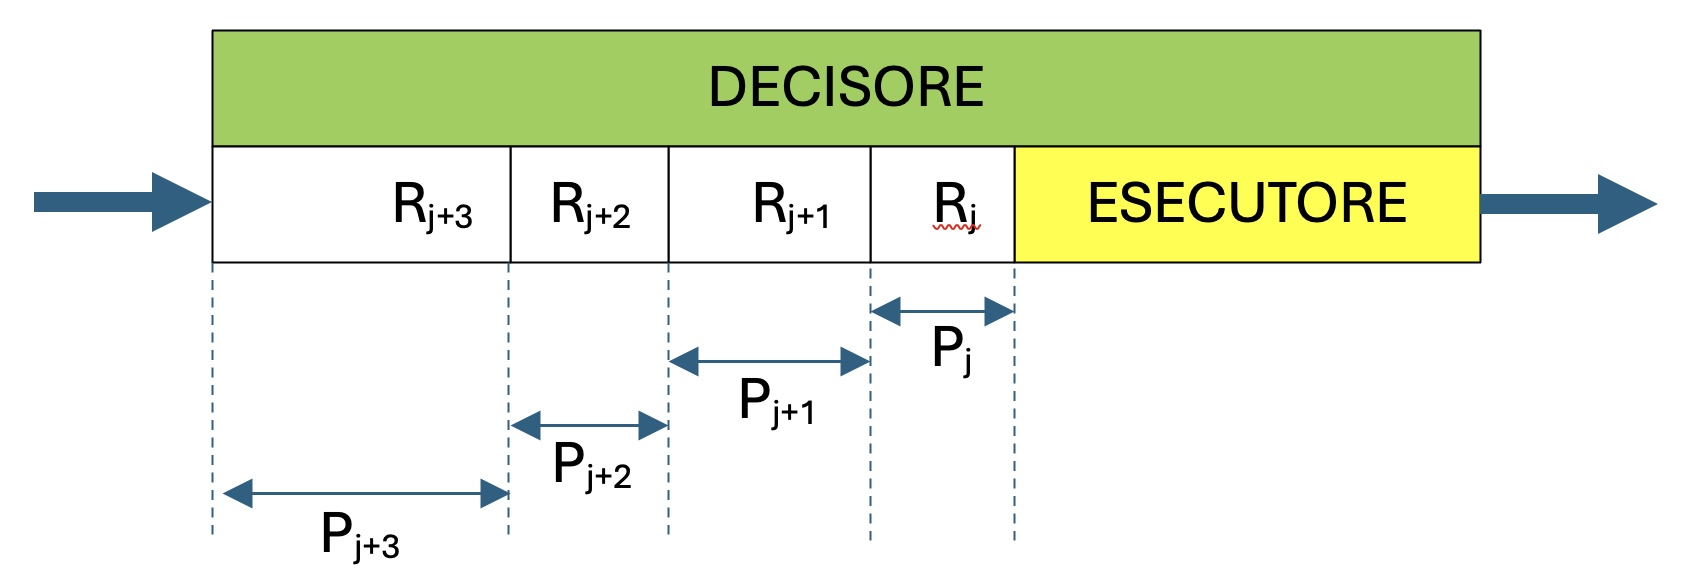
Ad ogni unità temporale ti il decisore dirà all'esecutore quale delle Rj in coda deve essere parzialmente eseguita. All'atto dell'esecuzione della Rj il peso corrispondente Pj viene diminuito di 1 e si va avanti nella timeline. Ovviamente simultaneamente posso arrivare nuove Rj+h e sempre nello stesso istante le Rj che hanno un Pj nullo vengono espulse in quanto completate (nel caso PROBLEMAj risolto).
In questo lavoro vengono presi in considerazione 5 tipi di decisori (molto comuni nel comportamento umano) e il software simula per milioni di volte la corrispondente attività della coda misurando la performance ottenuta. Le 5 strategie dei 5 decisori selezionati e le misure di performance sono:
3.1 Il burocrate (esecuzione sequenziale)
Molto comune in ambiti fortemente burocratizzati la strategia del "burocrate sequenziale" è gestire le Rj unicamente secondo il loro ordine di arrivo (First Come First Served) quindi ad ogni unità temporale il Pj sempre della Rj più anziana viene "consumata" fino a risolvere il solo PROBLEMAj. Esclusivamente dopo si passa al prossimo arrivato Rj+1 e così via. Il metodo è assolutamente meccanico e dal punto di vista umano implica assenza di necessità di decisioni ponderate.
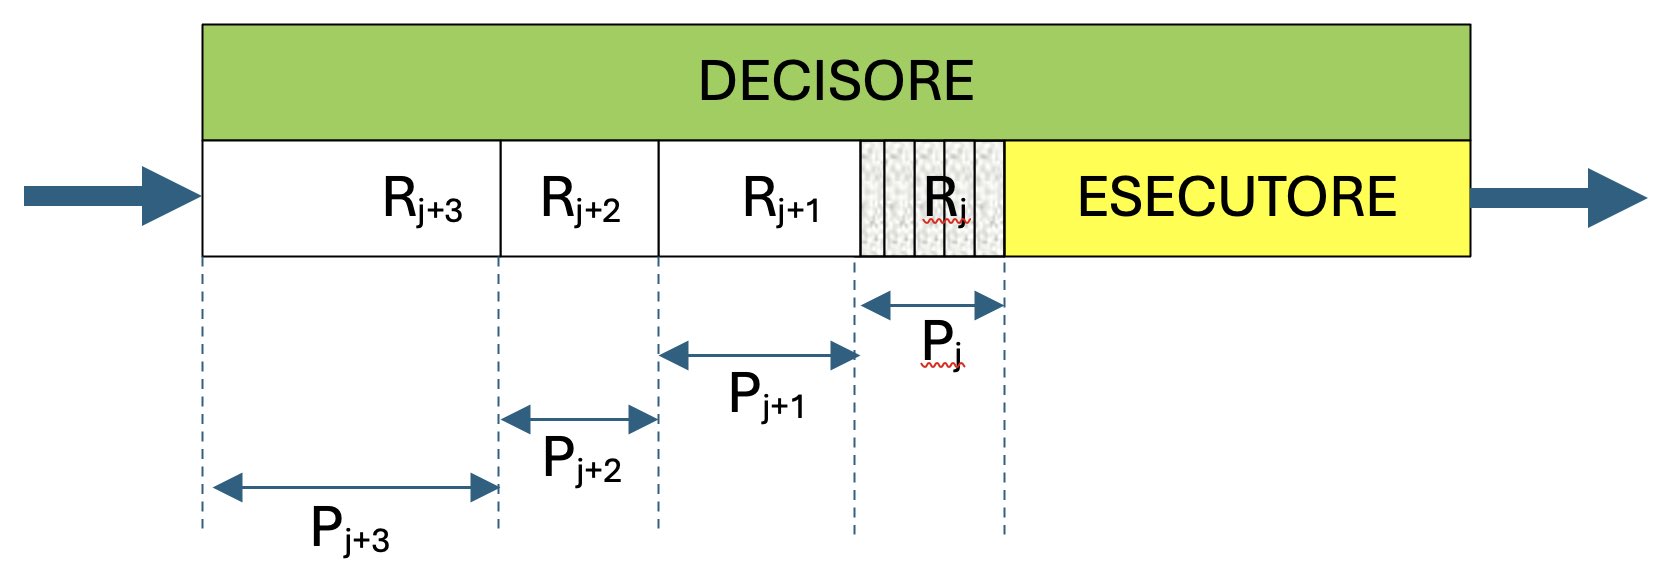
3.2 Il metodico tuttofare (esecuzione concorrente)
In questo caso la strategia è passare in rassegna tutte le richieste pervenute ed assegnare nell'ordine ad ognuna di esse uno slot temporale. E' come se ad ogni unità di tempo della linea temporale ci occupassimo di un problema differente. Questo naturalmente a rotazione tra le richieste in coda fino a quando non vengono consumate del tutto ed eliminate dal processo. Ad ogni unità di tempo ci aspettiamo quindi di diminuire il peso di uno dei problemi presenti da gestire, ciò a prescindere dalle loro caratteristiche. Da punto di vista umano il metodo richiede grande sangue freddo perchè di deve procedere a prescindere dai risultati che non è detto siano a breve.

3.3 Lo stacanovista instancabile (cerca peso maggiore)
La strategia è quella di selezionare sempre la richiesta a cui è associato il problema con il peso attualmente più grande nella coda. Si affronta quindi sul momento sempre il problema maggiore e questo in maniera dinamica e non statica. Dato infatti che il peso del problema diminuisce durante la sua esecuzione non è detto che sia sempre lo stesso problema ad essere selezionato. Dal punto di vista umano c'è una forma di ansia dietro questo metodo di scelta, ossia la paura che il problema più grande in coda, se non affrontato subito, possa portare al collasso l'intero sistema.
3.4 Il procrastinatore (cerca peso minore)
All'opposto della precedente si seleziona sempre la richiesta a cui è associato il problema con il peso minimo nella coda. Si affronta quindi sul momento sempre il problema minore e questo sempre in maniera dinamica e non statica. In questo caso il peso del problema (minimo) selezionato diminuisce durante la sua esecuzione facendo da attrattore per l'esecutore che tenderà a fossilizzarsi su di esso, ciò fatto salvo l'arrivo di altre richieste ancora più leggere. Dal punto di vista umano c'è una forma di leggerezza dietro questo metodo di scelta, ossia l'idea che per i problemi pesanti c'è sempre tempo in futuro.
3.5 Lo zuzzurellone (esecuzione a caso)
Questa strategia è stata da me inserita quale riferimento per la comparazione dei risultati. Il decisore, in questo caso, sceglie ad ogni unità di tempo della timeline a caso la richiesta da servire, senza tenere conto di nulla. Non so se umanamente ci sono persone che lavorano in questo modo (spero di no, soprattutto se i problemi da trattare sono seri), ad ogni modo non ho trovato di meglio di "zuzzurellone" quale termine per descriverlo.
Descritte le strategie dei decisori qui considerati, possiamo passare a dettagliare le misure della performance da calcolare mediante l'emulatore. Dato che trattasi di code semplici o code multiple gerarchiche (ad un solo livello), sono stati presi in considerazioni i seguenti valori:
1) Tempo extra di esecuzione: ogni problema ha un peso che, in questo lavoro, corrisponde proprio con il numero di unità temporali minime per risolverlo. La differenza tra il tempo effettivo impiegato dal decisore/esecutore per risolvere una richiesta e quello minimo previsto per la richiesta stessa è un notevole indicatore. Esso parla dell'efficienza del sistema di gestione ed esecuzione delle richieste nel suo complesso. Ovviamente l'emulatore lo calcola nel suo valore medio su milioni di tentativi.
2) Richieste attive per unità temporale: questo è il numero medio di richieste che sono da eseguire per ogni slot della timeline considerata. Esso indica la fatica del sistema di gestione ed esecuzione delle richieste nel suo complesso nello svolgere il suo lavoro.
3) Numero di volte che la coda è stata vuota: l'emulatore lo calcola in media su milioni di tentativi e percentualmente rispetto all'intera timeline. Una percentuale di "vuoto" della coda alta dice, ad esempio, che il sistema di gestione/esecuzione è sicuramente sovradimensionato. Tale parametro parla quindi di efficienza di trattazione dei problemi.
4) Numero di picco della coda: sempre calcolato in valore medio è il numero massimo di richieste che si sono accumulate in coda nella timeline considerata. Si tratta ovviamente di una valutazione di affollamento del sistema e della sua capacità di reagire a situazioni di crisi.
5) Numero di insoluti: al termine dell'esecuziuone e quindi alla fine della timeline, non tutte le richieste pervenute saranno necessariamente soddisfatte ovviamente, dipende dalle situazioni. Ad ogni modo il numero medio di richieste pervenute e insolute rapportato percentualmente al monte di richieste pervenute è un indicatore della bontà del sistema di gestione/esecuzione. Se ad esempio un sistema o una strategia ha tutti i parametri precedenti molto validi ma questo del 80% ciò indica che solo il 20% delle richieste pervenute può essere effettivamente gestita nel modo scelto, ossia il modo in questione non è utile nella pratica.
Per finire è stato anche realizzato un punteggio finale che combina tutti i 5 parametri visti rapportandoli al loro valore massimo e quindi normalizzandoli a 1 per poi sommarli algebricamente (il parametro (1) è negativo perchè non si desidera extra-time di esecuzione, il parametro (2) è negativo perchè non si vuole un sistema affaticato, il parametro (3) è positivo perchè si vuole una coda snella, il parametro (4) è negativo perchè non si vogliono affollamenti e infine il parametro (5) è negativo perchè non si vogliono insoluti dopo il processo).
4. Risultati dell'emulazione su coda singola
Vediamo di seguito alcuni dei risultati dell'emulatore per coda singola che, mediante un PRNG (generatore di numeri pseudo casuali) genera le richieste di servizio e le serve secondo le 5 strategie viste. Dal mio punto di vista ci sono state delle sorprese che dettaglio di seguito:
Ammetto che da lavoratore appassionato di problemi difficili mi aspettavo che lo "stacanovista" avesse la meglio sugli altri ma non è affatto così:
(a) vincitore senza eccezioni a prescindere dalla tipologia e numerosità dei problemi è il "metodico tuttofare", ossia la strategia dell'esecuzione concorrente intendendo che ad ogni passo bisogna considerare una parte di un problema diverso in una sorta di circolo risolutivo in cui si cambia sempre problema. Le prestazioni nel medio/lungo termine sono eccezionali: ottimo uso delle risorse, bassa occupazione della coda, insoluto finale ridotto al minimo. Occupa sempre il primo posto indiscusso ad eccezione della trattazione dei problemi a peso molto piccolo, nel qual caso prende il secondo posto. Una strategia vincente che è davvero difficile da applicare per un essere umano in quanto richiede estrema freddezza e distacco dai problemi stessi.
(b) lo "stacanovista" occupa sempre una posizione a metà tra le 5 strategie. Il suo occuparsi dei problemi più pesanti per primi lo porta ad un insoluto finale minimo, paragonabile a quello del vincitore, ma purtroppo c'è un grande extra-time medio di risoluzione dei problemi e soprattutto l'esecutore risulta sempre occupato con un tempo libero (situazione in cui non ci sono affatto problemi in coda) praticamente nullo percentualmente. In pratica questa strategia tende ad occupare velocemente tutte le risorse del sistema e con continuità generando un evidente "affaticamento".
(c) il "burocrate", strategia che si occupa dei problemi solo seguendo l'ordine di arrivo e uno alla volta fino a risolverlo, ottiene sorprendentemente ottimi risultati quando il peso dei problemi è molto piccolo, lavora bene per "prassi" su problemi piccoli e ripetitivi togliendo in tal caso il primo posto al "metodico tuttofare". Per problemi di peso medio occupa comunque il secondo posto (anche qui con mia sorpresa), mentre per problemi di peso molto alto scende ancora e si pone dietro addirittura allo "zuzzurellone".
(d) lo "zuzzurellone" anche ad intuito, dato che sceglie a caso, non lascia dubbi: egli ha sempre risultati negativi per problemi di peso piccolo, medio e alto, è quasi sempre l'ultimo ma, sorprendentemente, per problemi di altissimo peso si prende un ottimo secondo posto appena dietro al campione, il "metodico tuttofare". Quando il gioco diventa "troppo duro" scegliere a caso acquisisce un senso pratico.
(e) il "procrastinatore", la strategia che tende sempre a spostare a domani i problemi pesanti e risolvere solo quelli piccoli (tipo di strategia che onestamente non amo) è incollata all'ultima o penultima posizione sempre. Persino lo "zuzzurellone" ottiene risultati migliori dei suoi in diverse situazioni.
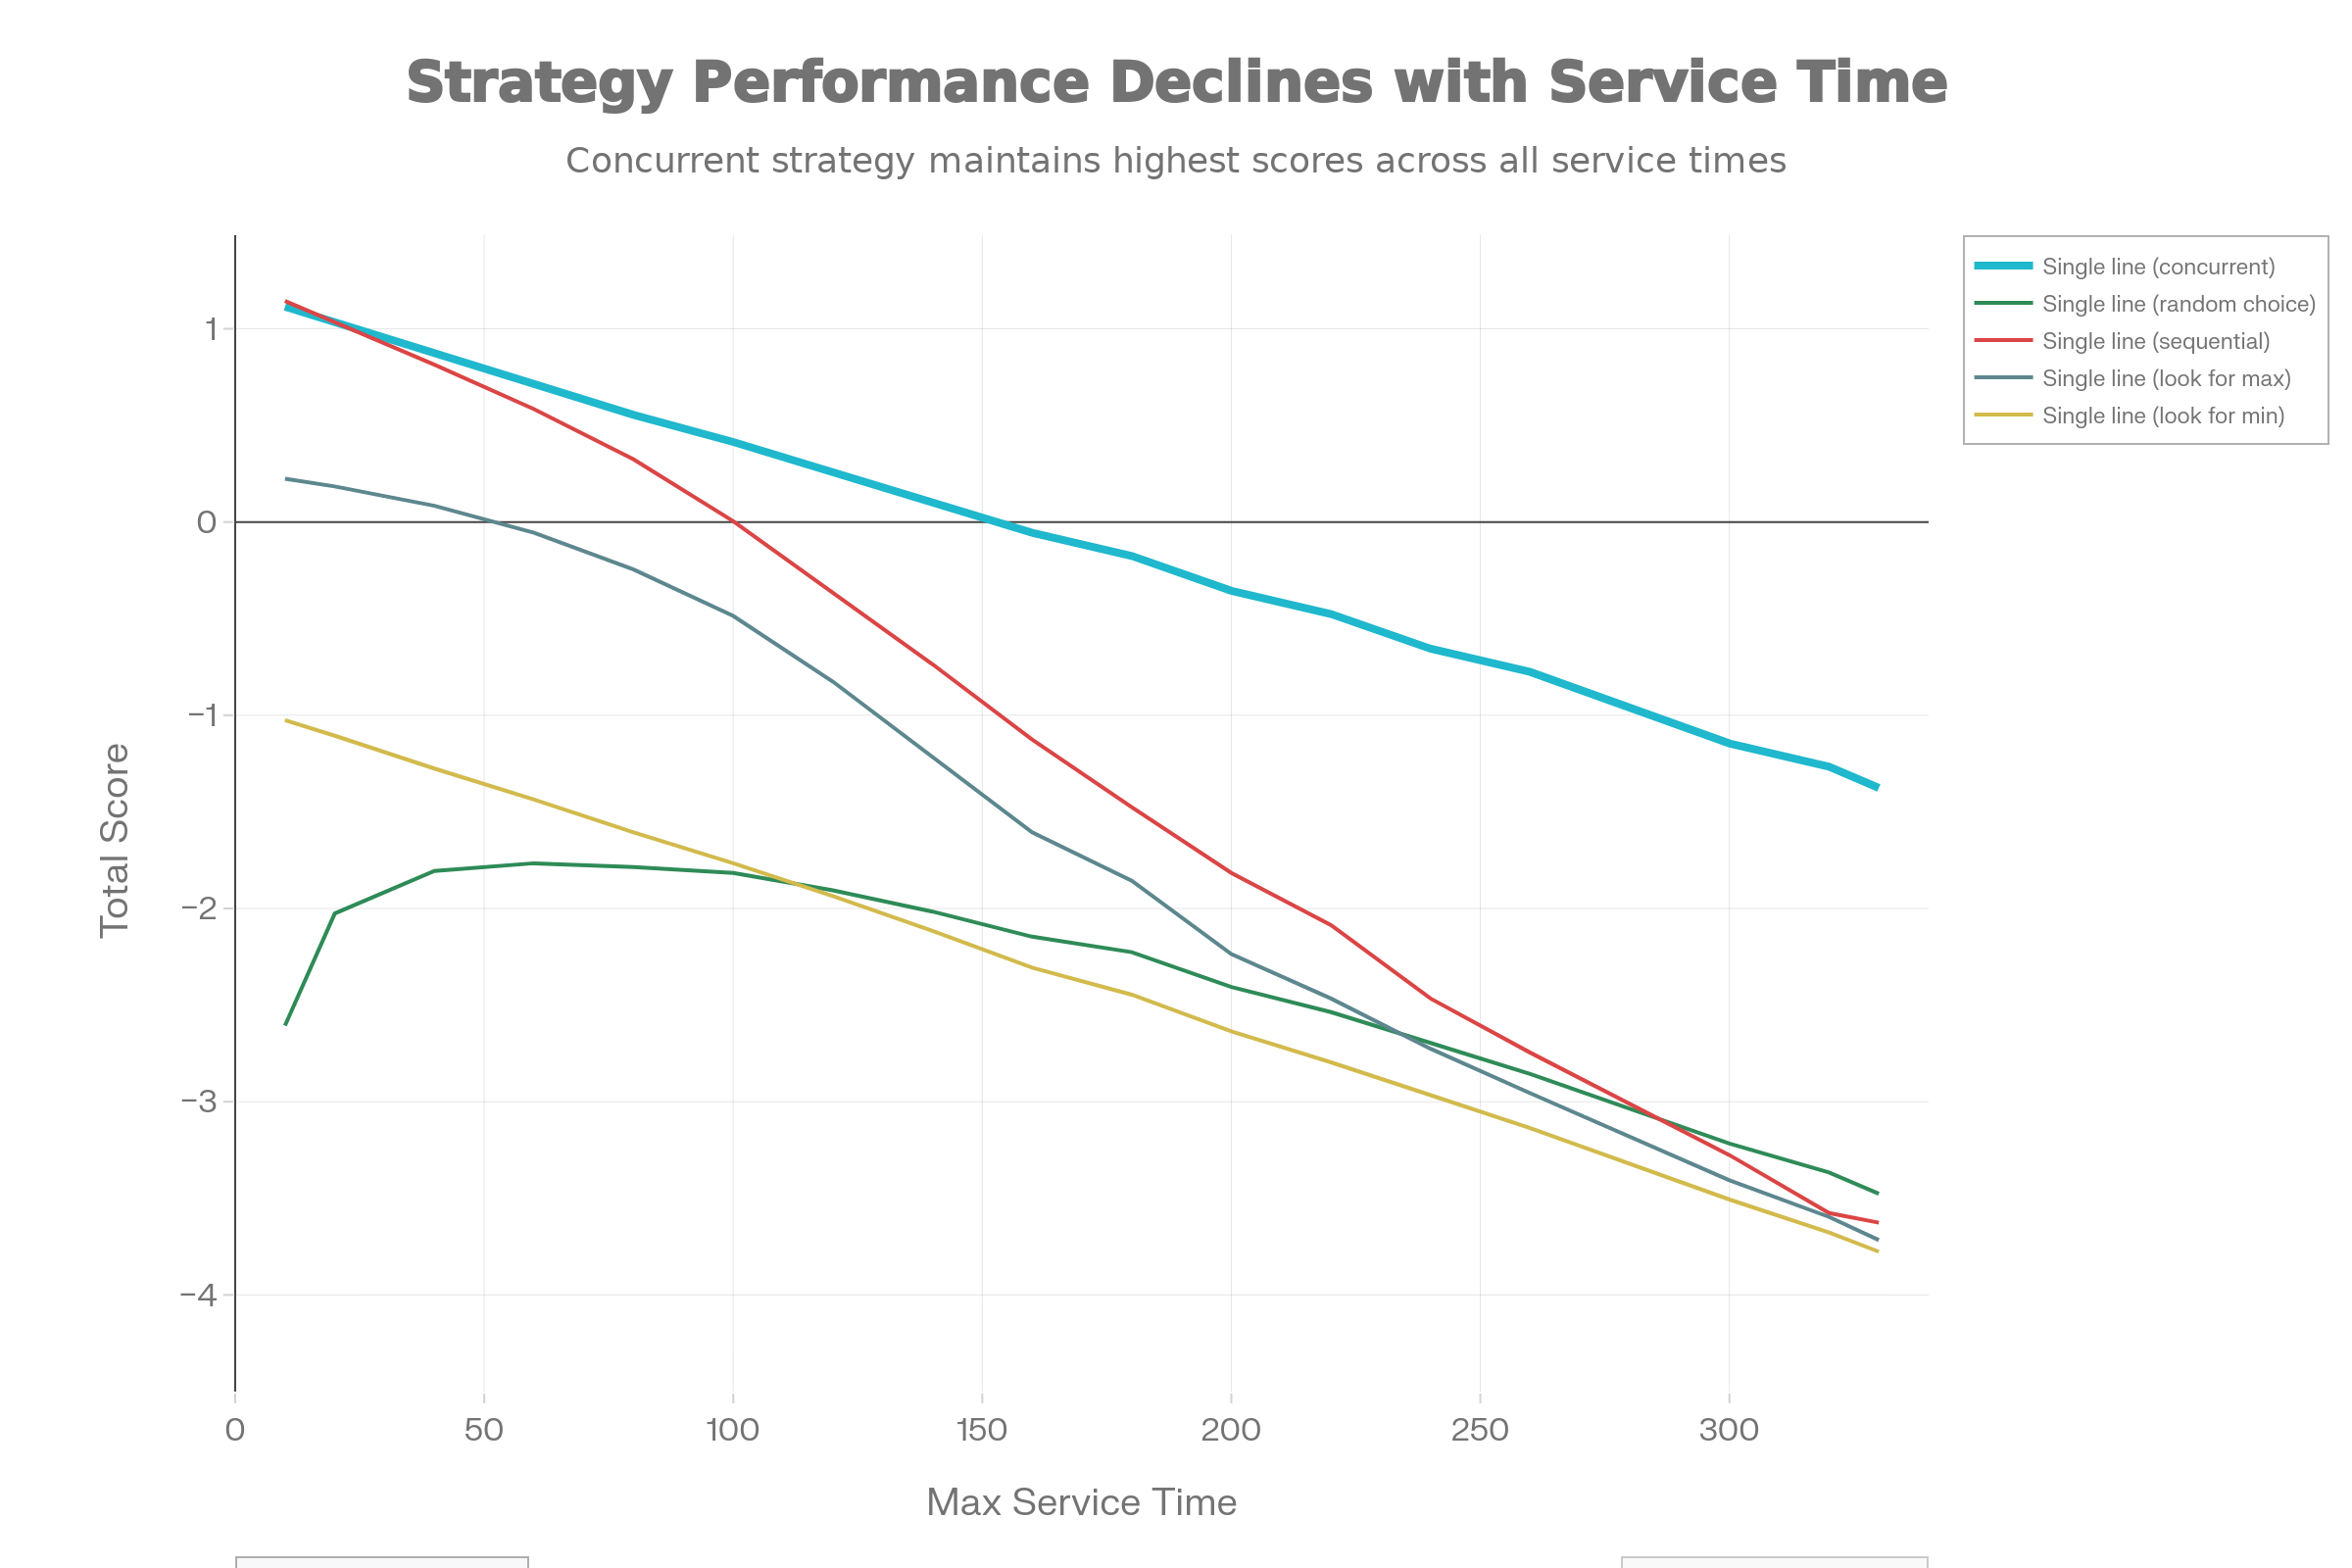
Grafico elaborato da Perplexity Pro AI
Riassumendo, riporto alcune libere conclusioni di natura più "umana" che lascio alla vostra interpretazione:
(.) è sempre bene evitare i "procrastinatori", non portano mai bene alla struttura decisionale ed esecutiva.
(..) non occorrono troppi "stacanovisti" in una buona struttura che eroga servizi, piuttosto occorrono "burocrati" e/o "metodici" a seconda del peso medio dei problemi più ricorrenti che si devono gestire.
(...) se ci sono solo molti problemi difficili e di altissimo peso da gestire in una struttura non si può fare altro che ricorrere a degli "zuzzurelloni" perchè in fin dei conti il problema è congenito e la struttura stessa deve essere re-ingegnerizzata, non basta prendere buoni manager e buoni esecutori.
5. Problemi prioritari e risultati emulazione
Ho studiato una variante precisa del software di emulazione che introduce richieste prioritarie a prescindere dalla strategia risolutiva che si considera. Tali richieste "speciali" arrivano a caso secondo una probabilità del 20% (parametro modificabile) rapportata a tutte le richieste e si correlano a problemi che non possono essere posti in secondo piano in nessun modo ma devono essere risolti immediatamente nelle unità temporali che seguono l'arrivo.
Dall'emulazione si è potuto verificare che, con una probabilità del 20% i risultati sono identici a quelli descritti sopra. Aumentando tale probabilità e facendola tendere ad 1.0 il principale cambiamento è che si converge verso una strategia "sequenziale", quella del "burocrate", in quanto tutti i problemi divengono prioritari e quindi si devono risolvere tutti nell'ordine di arrivo. Diminuendo la citata probabilità e facendola tendere a 0 si va verso un modello con assenza di richieste prioritarie che produce l'ottimo risultato di un minimo extra-time possibile di lavorazione delle richieste.
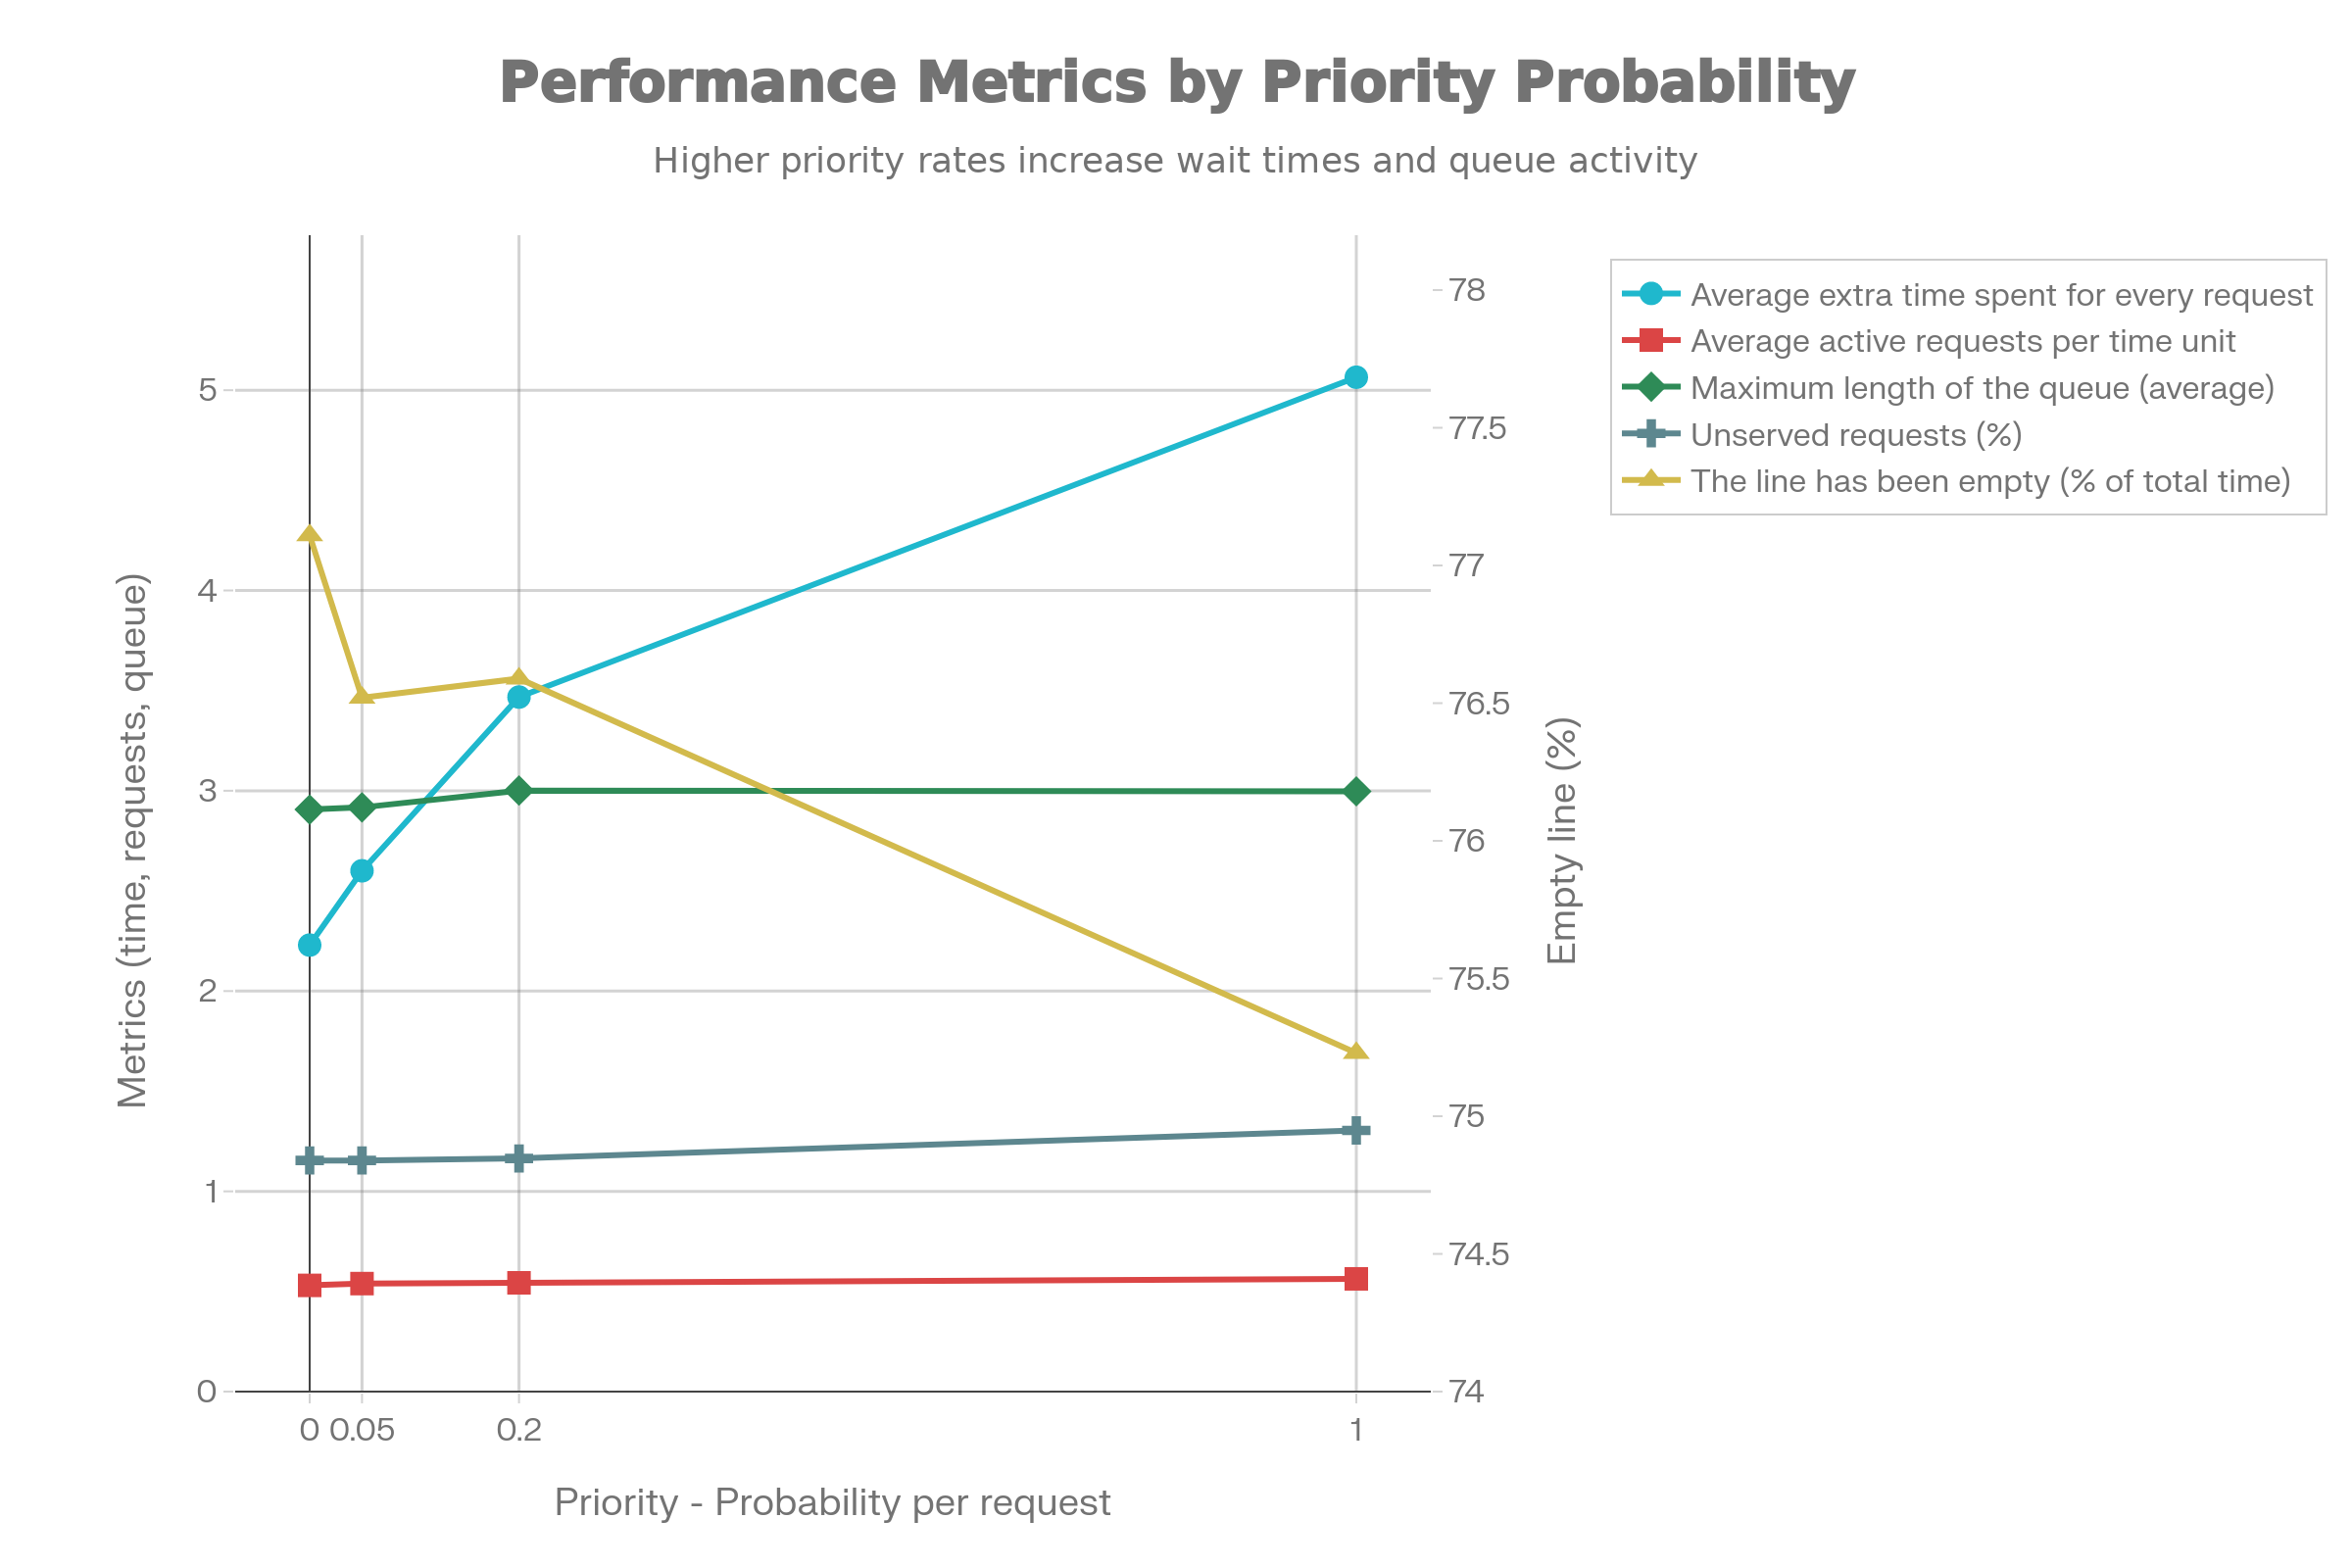
Grafico elaborato da Perplexity Pro AI
Anche qui riassumo riportando alcune libere conclusioni di natura più "umana" che lascio sempre alla vostra interpretazione:
(.) in natura è impossibile evitare che ci siano problemi prioritari ma troppi problemi prioritari portano il sistema di gestione a non funzionare in maniera efficiente determinandone un rallentamento globale, quindi:
(..) il meccanismo delle priorità per la gestione dei problemi va impiegato il meno possibile, soprattutto se la priorità è inserita da particolari decisori quale meccanismo di controllo esterno del processo nel suo insieme.
6. Problemi e decisioni gerarchiche
Il software permette di analizzare non solo code singole ma anche piccole gerarchie di code. In particolare il modello gerarchico molto semplice analizzato ed emulato, nonchè molto comune nella realtà di molte organizzazioni reali, è quello della gerarchia ad un solo livello con 1 capo e un certo numero n (modificabile) di collaboratori diretti.
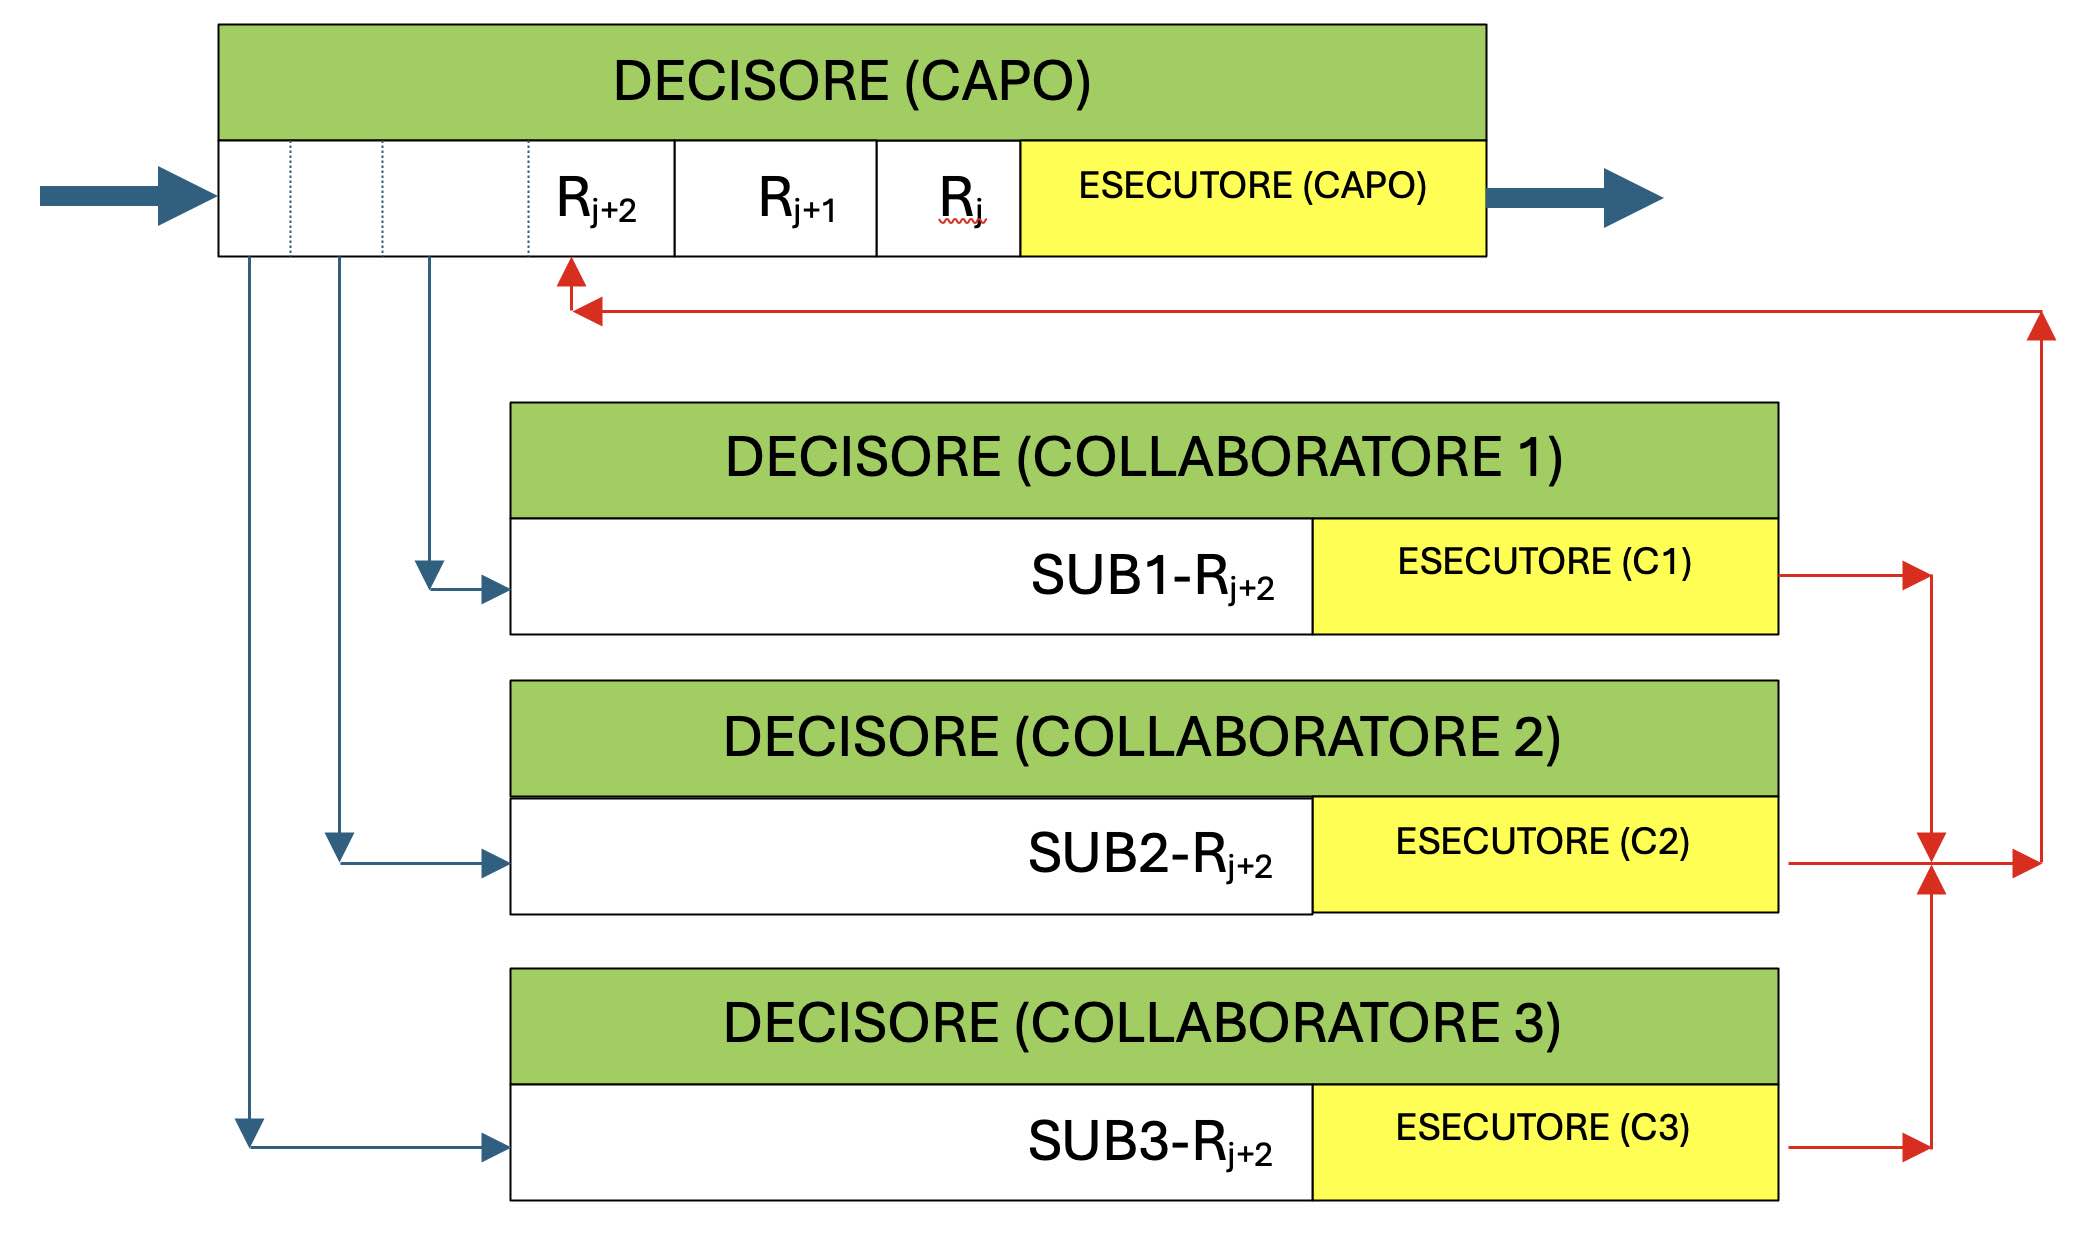
Come si può vedere dalla figura la Rj+2, attività selezionata dal decisore-capo per il servizio (a prescindere dalla strategia usata), viene suddivisa in 4 parti (sub-richieste) essendoci n = 3 collaboratori. Vige l'ipotesi, naturalmente, che tali parti possano essere processate in parallelo da più decisori/esecutori senza vincoli relativi. Una volta che i 3 collaboratori (tutti) hanno prodotto i risultati, questi vengono combinati e passati al capo per l'elaborazione finale della 4^ parte e quindi la produzione del risultato finale. L'unico a poter fornire il risultato finale all'esterno è il capo. Le 3 parti emulano il processo di delega da capo a collaboratore, la 4^ parte emula il processo di valutazione e integrazione dei risultati parziali in quelli finali da parte dell capo. Non è detto che tutte le richieste siano delegabili, nel software è impostata una probabilità del 80% (modificabile) che una richiesta risulti delegabile, quelle che non risultano tali devono essere eseguite totalmente e unicamente dal capo (tornando al modello di coda semplice).
Nel software, per semplificare, ogni richiesta delegabile vede il peso del corrispondente problema suddiviso in n+1 parti uguali. In pratica si sta parallelizzando la risoluzione del problema nel suo insieme, anche se il capo occupa comunque un posto di privilegio nella parallelizzazione.
Sia il capo che ognuno dei collaboratori può impiegare una delle 5 strategie decisionali individuate sopra. La gerarchia quindi non è solo strutturale ma differisce anche in base a come le citate strategie sono utilizzate.
6.1 Emulazione della gerarchia e risultati
Dopo milioni di tentativi le migliori performance sono state fornite dal modello gerarchico con capo "metodico tuttofare" e collaboratori "burocrati", quindi la strategia vincente per il capo della gerarchia è passare costantemente da un problema all'altro senza fare eccessive differenze e verificando ogni volta a che punto è la situazione con i collaboratori. Ai collaboratori non è richiesta, nel modello, eccessiva capacità decisionale per cui risultano efficienti quali esecutori sequenziali delle sub-richieste ricevute.
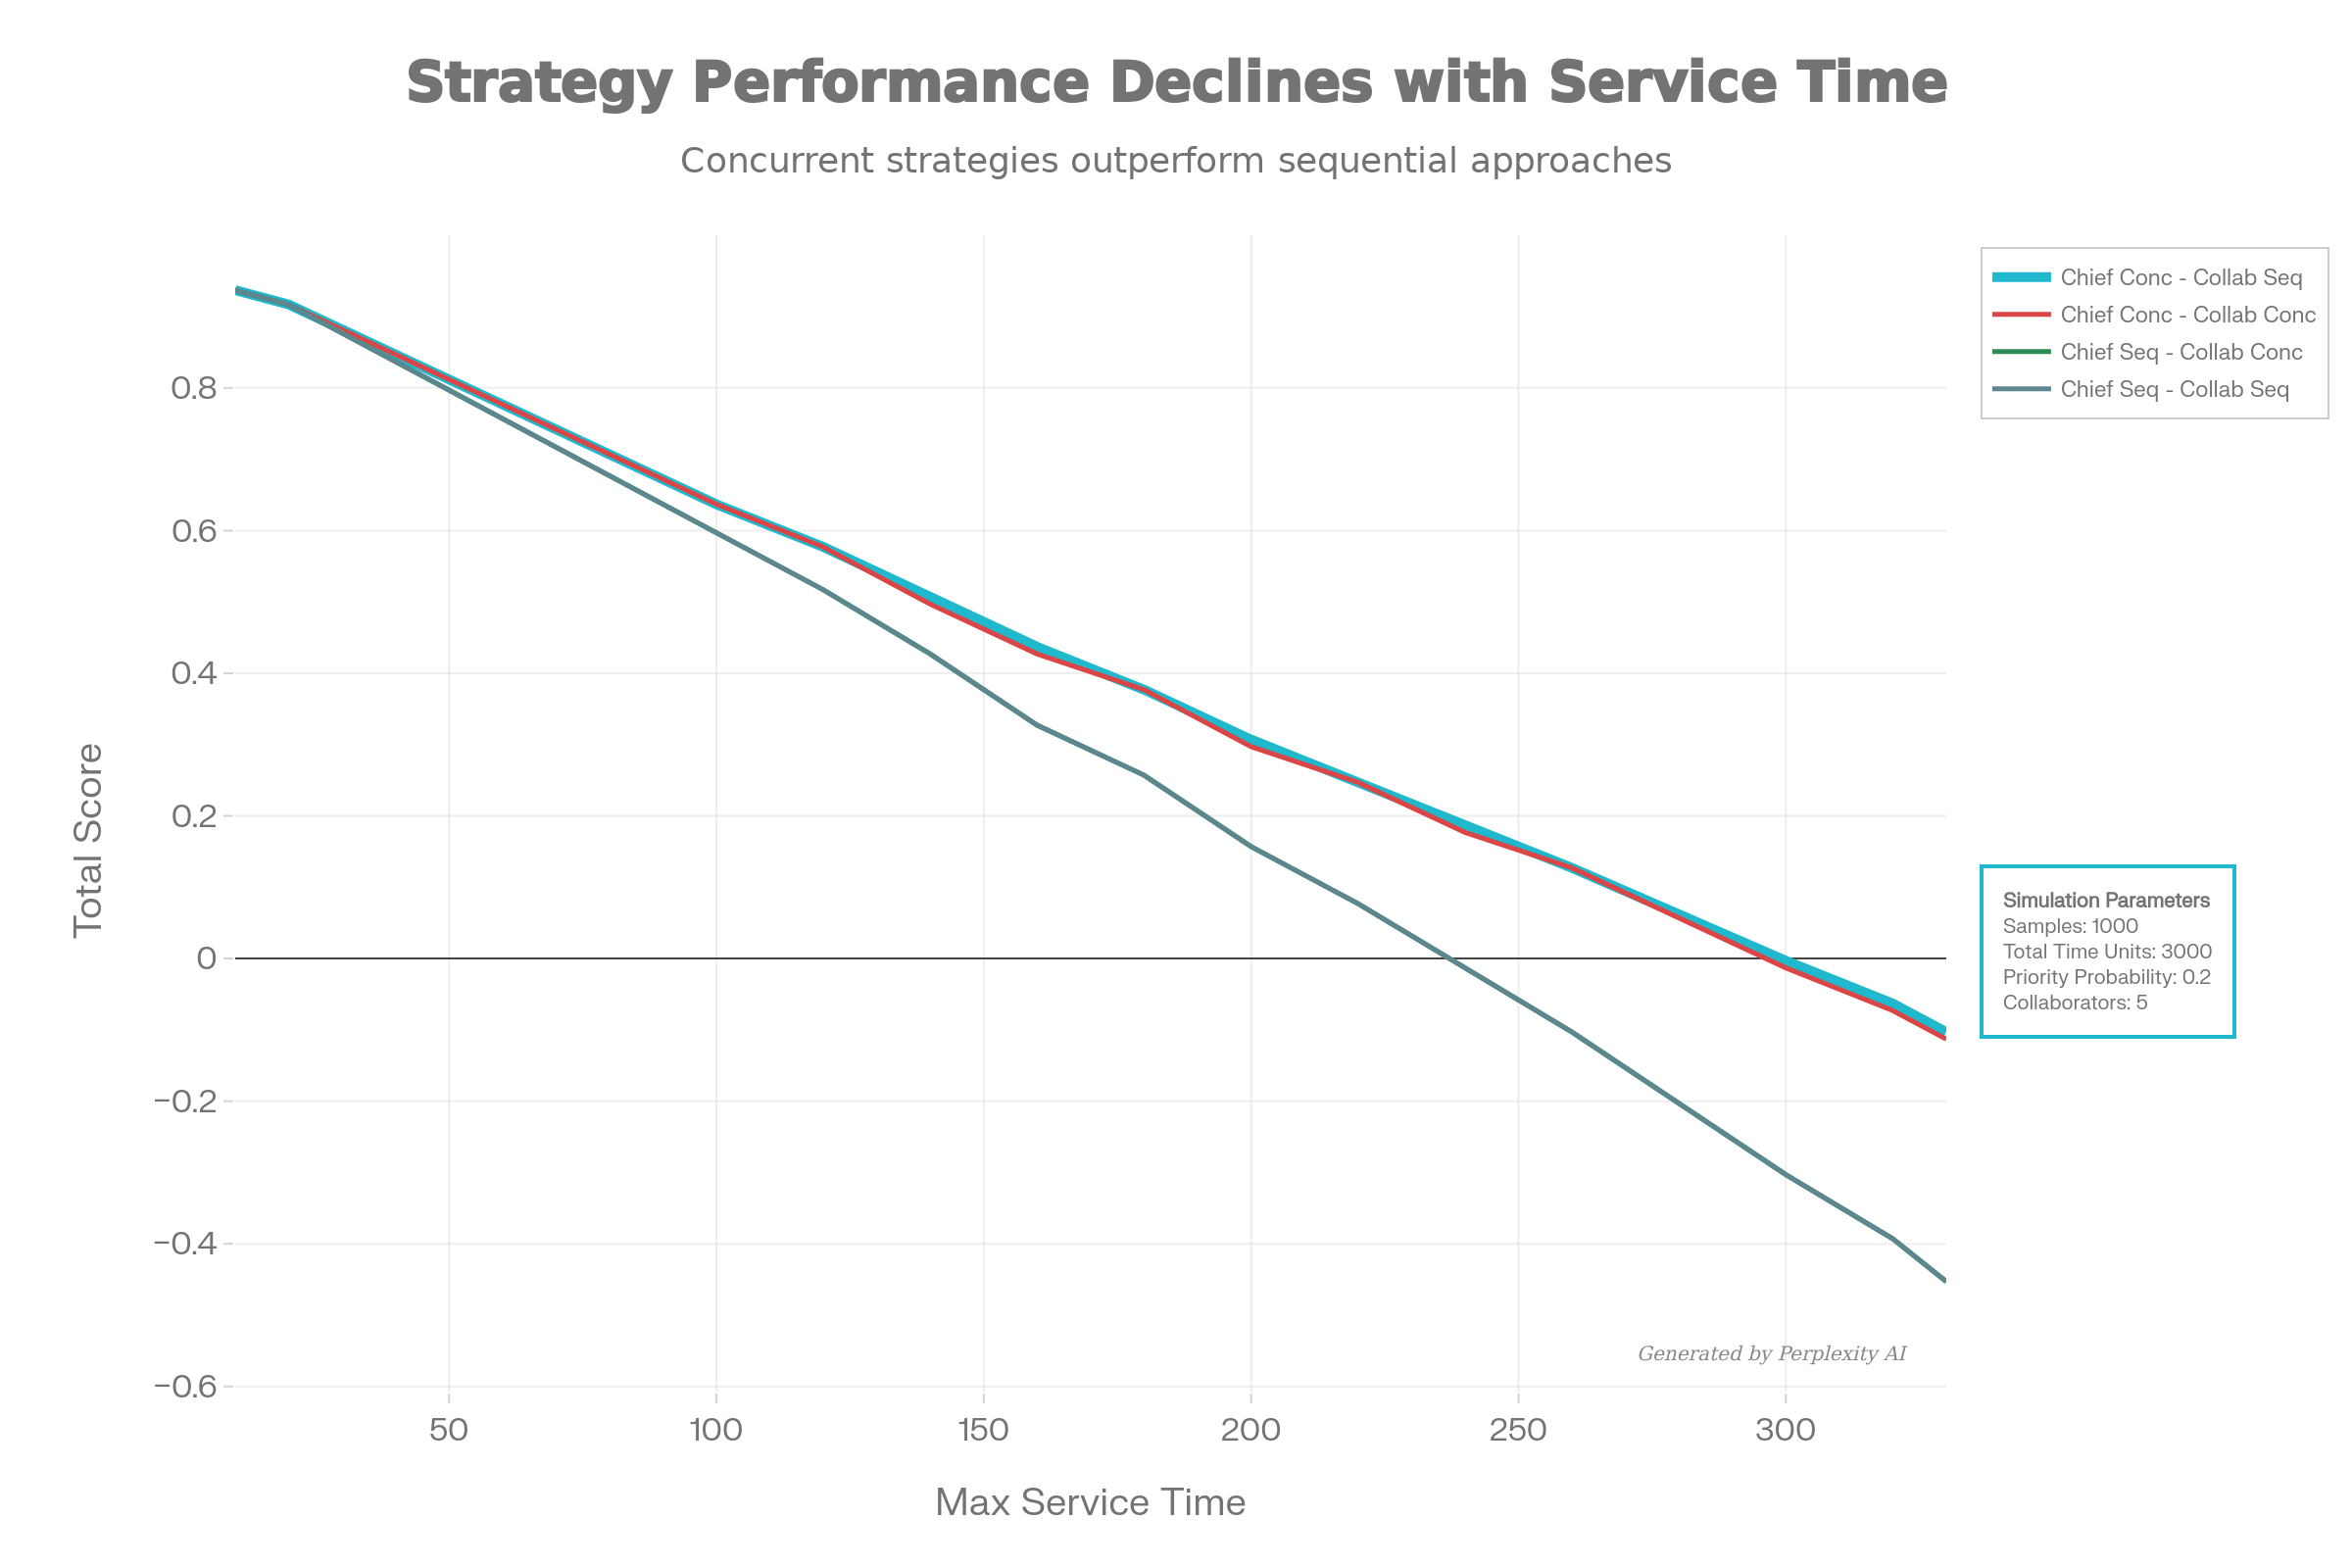
Grafico elaborato da Perplexity Pro AI
In generale la struttura gerarchica, nella simulazione, produce sempre risultati migliori di quella a coda singola operante sulle stesse richieste. Ciò non sorprende a seguito della parallelizzazione. Nemmeno sorprende il fatto che il vantaggio della parallelizzazione si senta soprattutto per problemi con peso maggiore. Infine qualcuno potrebbe pensare perchè il risultato di una gerarchia capo-concorrente + collaboratori-sequernziali sia migliore di una in cui tutti i nodi siano concorrenti: nel secondo caso i collaboratori ottimizzano il loro lavoro nel medio/lungo termine ma non producono i risultati velocemente per il capo ed essendo solo il capo a presentare i risultati finali della struttura alla fine si percepisce un rallentamento.
7. Breve descizione del software
Il software che ho costruito, liberamente disponibile su:
github.com/mmattiucci2024/service_line
si compone di 3 classi di oggetti e fondamentalmente di due procedure: una per simulare l'arrivo delle richieste in una coda singola con enfasi sul fenomeno del clustering e l'altra per emulare code di diversa struttura e con diverse tipologie di strategie di gestione delle richieste al fine di comparare i risultati mediante valutazione dei parametri di performance indicati nel precedente paragrafo 3.
Esso è dettagliatamente commentato, quasi linea per linea, e si può facilmente estendere ad altre strategie di gestione delle richieste e a code più complesse, ciò anche grazie alla sua struttura ad oggetti. I parametri globali della simulazione sono impostabili all'inizio del software e comunque vengono evidenziati alla fine dell'esecuzione.
7.1 Le classi
Nel dettaglio, il codice python contempla le seguenti 3 classi di oggetti:
a) myServiceRequest(): che realizza il concetto di richiesta su una linea temporale discreta e permette di "servirla" in un singolo slot temporale agendo sul suo stato (ACTIVE, WAITING, COMPLETION).
b) myServiceLine(): che struttura e permette di far funzionare una coda di gestione ed esecuzione di richieste di servizi. Esso consente di inserire nuove richieste, gestire una coda di richieste esistenti e processare le richieste in coda in un unico slot temporale secondo priorità e strategie (in questa classe di oggetti è possibile espandere questo metodo per inserire nuove strategie o ad esempio nuove tipologie di priorità, ecc.). Infine permette anche una simulazione delle attività della coda di servici per un'intera linea temporale.
c) myServiceLineHierarchy(): di principio simile alla precedente ma struttura e fa funzionare una coda di code in forma gerarchica. Questa classe, sfruttando la precedente, realizza una struttura complessa di frazionamento di richieste e servizi che permette di eseguire una simulazione su un'intera linea temporale.
Sia (b) che (c) rilevano e memorizzano tutta una serie di parametri di performance, poi impiegati dalle successive procedure per presentare un output consistente.
7.2 Le procedure
Nel dettaglio, il codice python permette l'impiego, all'utente finale, di due fondamentali procedure:
(-) show_clusters_of_requests(strategy): esegue una simulazione di una coda semplice con gli arrivi delle richieste evidenziando i cluster nel dettaglio. La strategia è impostabile come input della procedura e per default è quella sequenziale (burocrate). Produce anche un grafico elementare con colori diversi per rappresentare i cluster di richieste.
(--) emulate_multiple_lines_multiple_strategies(): realizza e simula 9 esempi di sistemi di coda (5 semplici con le 5 strategie previste e 4 complesse con combinazioni delle 5 strategie previste). Essa crea tutti gli oggetti previsti, ne avvia il lavoro di simulazione, raccoglie i dati di performance e li presenta, ordinati per efficienza, all'utente alla fine dell'elaborazione.
Per finire è il caso di sottolineare che la funzione get_total_score(results) calcola la valutazione finale di ogni simulazione, essa combina i parametri individuati nel precedente paragrafo 3 prima normalizzandoli e poi sommandoli algebricamente tra loro.
8. Conclusioni
Anche per coloro che non hanno avuto la pazienza di leggere tutto il presente articolo e nemmeno di visionare o usare il software su github, riporto di seguito, sintetizzandole, le conclusioni delle simulazioni numeriche svolte in diversi giorni e anche rappresentate in alcuni grafici precedenti. Si tratta di conclusioni qualitative da me elaborate, si può ovviamente essere in disaccordo, possono mancare degli aspetti, nel senso che la simulazione potrebbe essere resa maggiormente omnicomprensiva, in ogni caso il software è a disposizione di tutti e se lo si vuole estendere si possono approfondire molti aspetti.
(0) Se una struttura di servizi riceve continuamente richieste di trattare problemi complessi ad alta probabilità di arrivo ciò richiede di rivedere l'intero sistema perchè ci sono problemi congeniti, non ha senso studiare metodi migliori o più efficaci di gestione delle code.
(1) Gli arrivi random di richieste per problemi rari (a bassa probabilità di presentarsi per ogni slot di una linea temporale discreta) sono segnalatori che dicono di prepararsi all'approssimarsi di altri problemi simili nel vicino futuro. Se si gestisce una struttura complessa la strategia decisionale migliore di fronte all'arrivo del primo evento raro dopo tempo (inizio del cluster) non è quella di affrontarlo come sempre ma piuttosto riunire le risorse per prepararsi ad un effetto a catena.
(2) In un'organizzazione è sempre bene evitare i "procrastinatori", non portano mai bene alla struttura decisionale ed esecutiva. Non si tratta del fatto che la rallentano ma piuttosto che nel lungo termine la distruggono.
(3) In un'organizzazione alla ricerca di ben funzionare a regime e quindi nel medio/lungo termine, 'non occorrono troppi "stacanovisti" atti ad erogare servizi, piuttosto occorrono "burocrati" e/o "metodici" a seconda del peso medio dei problemi più ricorrenti che si devono gestire. I burocrati soddisfano le richieste sequenzialmente, una dopo l'altra e con poca strategia, i metodici si occupano a rotazione veloce di tutti i problemi che hanno in coda (azione concorrente), a prescindere dalle loro caratteristiche intrinseche.
(4) Sebbene in natura sia impossibile evitare i problemi prioritari, qualora all'organizzazione pervengano richieste inerenti a troppi problemi prioritari, essi portano il sistema di gestione a non funzionare in maniera efficiente determinandone un rallentamento globale.
(5) Qualora possibile è bene evitare quei meccanismi che permettono di impostare priorità per la gestione dei problemi, soprattutto se la priorità è inserita da particolari decisori quale metodo di controllo esterno del processo nel suo insieme.
(6) In generale la struttura a coda multipla gerarchica, nella simulazione, produce risultati sempre migliori di quella a coda singola operante sulle stesse richieste. Ciò discende dalla parallelizzazione nella risoluzione dei problemi che si sente soprattutto per problemi con peso maggiore.
(7) Un sistema con gerarchia in cui il capo opera in maniera concorrente e i suoi collaboratori in maniera sequenziale ha una migliore performance globale. Si sottolinea che qualora i collaboratori operassero in maniera concorrente come il capo (su più problemi simultaneamente) essi ottimizzerebbero il loro lavoro nel medio/lungo termine ma non produrrebbero i risultati velocemente per lo stesso capo determinando un rallentamento globale dato che è solo il capo a rappresentare i risultati finali della struttura.
Cookie(s) & Privacy
Questo sito web, per quanto da me programmato e realizzato in php, non emette cookie, non effettua il profiling dell'utente e non raccoglie vostri dati personali. Alcuni cookie possono essere emessi dal cloud che lo supporta, strumento al di fuori della possibilità di controllo dello scrivente. Per qualsiasi dubbio in proposito smettete immediatamente la navigazione.marcomattiucci.it
Informatica:
Intelligenza artificiale:
- Home(AI)
- AI forte
- AI debole
- AI distribuita
- AI sociale
- Singolaritá
- La Logica
- AI e Leggi
- AI ed Etica
- Tris parte 1
- Decision making
- Tris parte 2 (LLM)